
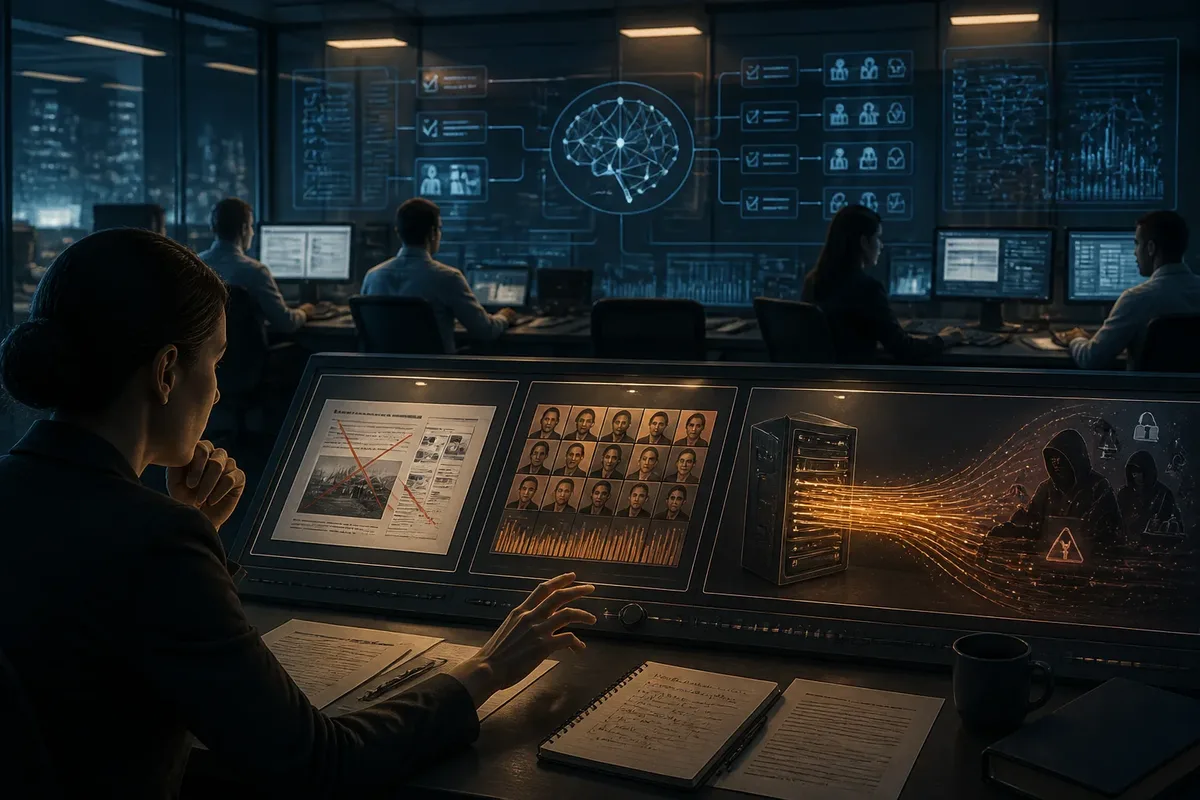
Le coût d’une erreur d’intelligence artificielle va d’une simple correction de texte à une décision injuste, une fuite de données ou une interruption d’activité. Les principaux risques de l’intelligence artificielle concernent les erreurs et hallucinations, les biais et discriminations, la fuite de données, les cyberattaques, les deepfakes, la dépendance aux outils et la perte de contrôle humain. Ils se réduisent par la vérification humaine, la protection des données, une gouvernance claire, des tests de sécurité et une surveillance continue.
L’analyse des risques de l’IA doit donc séparer les faits observables des scénarios prospectifs. Une réponse fausse produite par un assistant, une donnée confidentielle copiée dans un service externe et une décision automatisée impossible à contester ne relèvent pas du même mécanisme, même si tous trois peuvent se renforcer dans une organisation mal préparée.
Comment analyser les risques de l’IA sans confondre erreur et menace ?
Un risque d’IA se mesure par la combinaison de sa probabilité, de la gravité du dommage, de la capacité à détecter l’erreur et de la possibilité de revenir sur la décision. Une erreur fréquente et immédiatement visible reste parfois maîtrisable, tandis qu’une défaillance rare, silencieuse et irréversible exige un niveau de contrôle bien supérieur.
La gravité dépend du contexte d’usage, pas du seul modèle. Un texte marketing approximatif se corrige facilement. Une information erronée utilisée pour refuser un crédit, orienter un patient ou filtrer une candidature engage d’autres conséquences.
D’abord, il faut identifier la tâche exacte confiée au système : produire, classer, recommander, décider ou déclencher une action. Cette distinction évite de mettre sur le même plan un générateur d’idées et un outil qui modifie automatiquement un dossier client.
Ensuite, l’analyse doit examiner quatre indicateurs concrets :
- Fréquence : combien d’erreurs apparaissent sur un échantillon représentatif ?
- Détectabilité : l’utilisateur repère-t-il facilement une réponse fausse ou biaisée ?
- Réversibilité : peut-on annuler la décision sans dommage durable ?
- Exposition : le système traite-t-il des données personnelles, financières ou stratégiques ?
Mais une moyenne globale ne suffit pas à établir la fiabilité d’un système. Elle peut masquer des résultats très différents selon la langue, le groupe concerné, le type de document, la qualité des données ou la situation inhabituelle soumise au modèle.
Les données publiques sur les incidents restent également incomplètes. Les entreprises ne déclarent pas toutes leurs erreurs, les définitions d’un incident varient et les tests en laboratoire ne reproduisent pas toujours les usages réels.
Un système peut sembler performant en démonstration et devenir fragile après son déploiement, lorsque les utilisateurs le sollicitent dans des cas non prévus, combinent plusieurs outils ou cessent de vérifier ses sorties.
Pourquoi les erreurs et hallucinations de l’IA restent-elles le risque le plus visible ?
Les erreurs de l’IA sont déjà observables dans les usages courants : réponse inventée, calcul faux, référence inexistante, mauvaise interprétation d’une consigne ou résumé qui omet une information décisive. Elles deviennent dangereuses lorsque la formulation assurée du système pousse l’utilisateur à confondre fluidité et exactitude.
D’abord, les hallucinations désignent des contenus présentés comme vrais alors qu’ils sont faux, invérifiables ou fabriqués. Les formulations utilisées dans les sources disponibles parlent tantôt de fausses réponses, tantôt de réponses totalement inventées : l’écart de vocabulaire décrit une même difficulté, celle d’un contenu plausible sans garantie factuelle.
Les principales erreurs prennent plusieurs formes :
- une date, un nom ou une référence bibliographique inventés ;
- un raisonnement numérique qui semble cohérent, mais aboutit à un résultat faux ;
- un contresens causé par une consigne ambiguë ou un contexte incomplet ;
- une citation tronquée, attribuée au mauvais auteur ou sortie de son périmètre ;
- une réponse correcte en général, appliquée au mauvais dossier.
Or le ton ne fournit aucun signal fiable de vérité. Un modèle peut produire une phrase nette, structurée et convaincante sans disposer d’une vérification externe au moment où il répond.
La difficulté augmente lorsque l’utilisateur ne possède pas les connaissances nécessaires pour contrôler le résultat. Dans ce cas, la réponse générée devient la source de référence par défaut, surtout lorsque le délai est court ou que la hiérarchie valorise la rapidité.
Une règle simple s’impose pour les usages sensibles : demander la source, vérifier la source, puis contrôler que cette source dit réellement ce que le système lui attribue. Cette séquence ne transforme pas l’IA en outil fiable par magie ; elle réduit le risque d’erreur non détectée.
Ne confiez pas une décision irréversible à une réponse non vérifiée.
Dans un usage créatif, une erreur peut coûter quelques minutes de réécriture. Dans un usage administratif, elle peut retarder une démarche ou orienter un agent vers le mauvais formulaire. En santé, en droit, dans le crédit ou dans la sécurité, le même défaut prend une gravité supérieure parce que le lecteur peut agir sur la base d’une information fausse, sans comprendre ce qui manque.
Les erreurs de calcul méritent une vigilance particulière. Une IA générative peut expliquer correctement une méthode et se tromper dans l’application numérique, notamment lorsque plusieurs hypothèses, unités ou périodes interviennent.
La vérification doit alors être indépendante : document officiel, calcul séparé, professionnel compétent ou outil spécialisé dont le fonctionnement est connu. Demander à la même IA de contrôler sa propre réponse apporte un signal supplémentaire, pas une preuve suffisante.
Comment les biais de l’IA peuvent-ils produire des décisions injustes ?
Les biais algorithmiques apparaissent lorsque les données, les catégories, les objectifs ou le contexte d’utilisation favorisent systématiquement certains profils et en désavantagent d’autres. Un système peut être performant en moyenne tout en produisant des résultats sensiblement moins fiables pour un groupe particulier, avec des conséquences concrètes sur l’accès à un emploi, un service ou un financement.
D’abord, il faut distinguer trois niveaux souvent mélangés : la représentation inégale d’un groupe dans les données, la qualité variable des prédictions et la discrimination produite par la décision finale. Le biais des données décrit une origine possible ; la discrimination décrit un effet subi.
Un jeu de données peut sous-représenter certaines voix, contenir des décisions historiques déjà inéquitables ou utiliser des catégories trop pauvres pour décrire les personnes. L’algorithme apprend alors une régularité qui reflète partiellement le passé, même si personne n’a écrit une instruction explicitement discriminatoire.
Dans le recrutement, un modèle peut privilégier des parcours qui ressemblent aux recrutements antérieurs. Pour le crédit, une variable apparemment neutre peut servir de proxy à une caractéristique protégée. Dans l’éducation, une prédiction de réussite peut reproduire les inégalités d’accès aux ressources plutôt que mesurer le potentiel individuel.
En reconnaissance d’images ou dans la modération, la performance varie aussi selon les visages, les accents, les langues et les contextes culturels. Une erreur de classification peut entraîner une exclusion automatique, la suppression d’un contenu légitime ou une suspicion injustifiée.
Pour chaque cas, il faut séparer le constat mesuré, le mécanisme supposé et la limite de généralisation. Un écart observé dans un échantillon ne permet pas automatiquement de conclure que le même écart existe dans tous les pays, toutes les versions ou toutes les populations.
Pourtant, aucun test unique ne prouve une neutralité totale. Améliorer un indicateur d’équité peut dégrader un autre, et une correction statistique ne résout pas nécessairement un problème de catégories, d’objectif métier ou de décision humaine.
La gouvernance des données doit donc intervenir avant l’entraînement et après le déploiement : origine des données, critères de sélection, qualité des étiquettes, taux d’erreur par groupe, procédure de recours et conditions de retrait du système.
Le règlement européen sur l’intelligence artificielle prévoit une gouvernance des données pour certains systèmes à haut risque à son article 10. L’article 14 prévoit également une supervision humaine adaptée au système et à son contexte d’usage.
Dans le recrutement, le crédit, la santé ou la sécurité publique, l’IA ne doit pas devenir l’unique arbitre. Le professionnel responsable doit pouvoir comprendre suffisamment le résultat, le contester, demander une nouvelle analyse et suspendre la procédure lorsqu’un signal d’injustice apparaît.
Quelles fuites de données et attaques l’IA peut-elle faciliter ?
Les risques liés aux données et à la cybersécurité concernent à la fois l’outil utilisé et l’usage qui en est fait. Une information sensible peut être saisie dans un service externe, récupérée par un accès mal protégé ou exposée par une intégration défectueuse ; l’IA peut aussi accélérer le phishing, la fraude et l’exploitation de vulnérabilités.
D’abord, une organisation doit classer les données avant de choisir un outil : données publiques, internes, personnelles, confidentielles ou réglementées. Une règle pratique s’impose : une donnée qui ne doit pas être envoyée à un prestataire inconnu ne doit pas être copiée dans son assistant conversationnel.
Les risques de confidentialité ne se limitent pas à la conservation d’un prompt. Ils incluent l’accès des employés, les journaux techniques, les connecteurs vers d’autres applications, les comptes mal configurés et la réutilisation éventuelle des données selon les conditions du service.
Une fuite peut aussi venir d’un document joint par erreur, d’un copier-coller massif ou d’une extension de navigateur qui transmet le contenu d’une page à un modèle. La multiplication des services gratuits ou non validés crée une forme de « shadow IA » : l’organisation ne sait plus quels outils traitent ses informations.
Les recommandations du Centre canadien pour la cybersécurité sont organisées autour de trois piliers et présentent dix mesures de sécurité pour les organisations qui utilisent l’IA. Cette approche rappelle que la protection ne repose pas seulement sur le modèle, mais aussi sur les comptes, les accès, les données et la surveillance.
La cybersécurité ajoute des menaces spécifiques :
- Injection d’invites : une instruction cachée tente de détourner le comportement du système ou de lui faire divulguer des informations ;
- Empoisonnement des données : des données manipulées influencent l’entraînement, la recherche documentaire ou les résultats ;
- Vol de modèle : un acteur cherche à reproduire ou extraire un système entraîné ;
- Réponse mal protégée : un résultat généré déclenche une action sans contrôle suffisant.
Mais l’IA amplifie surtout des techniques déjà connues. Les fraudeurs peuvent produire des messages mieux rédigés, imiter une voix, fabriquer une image crédible ou personnaliser un courriel à partir d’informations publiques.
Les deepfakes et l’usurpation d’identité rendent la vérification plus exigeante. Une voix familière ne suffit plus à confirmer une demande de virement, pas davantage qu’une vidéo ou une capture d’écran ne prouve l’origine d’un message.
La bonne réponse est procédurale : rappeler un interlocuteur sur un numéro connu, utiliser une double validation, vérifier le domaine, limiter les droits d’accès et conserver une trace des décisions. La vitesse promise par l’automatisation ne justifie pas la suppression du contrôle.
Les utilisateurs qui créent des contenus marketing peuvent aussi réduire leur exposition en séparant les outils de rédaction, les données clients et les systèmes de production. Pour comparer des solutions sans leur confier immédiatement des informations commerciales, une analyse des logiciels de rédaction assistée par IA doit être complétée par l’examen de leurs conditions de traitement des données.
Pourquoi la dépendance organisationnelle ressemble-t-elle déjà à une perte de contrôle ?
La perte de contrôle ne commence pas avec une machine autonome qui poursuivrait un objectif caché. Elle apparaît déjà lorsqu’une équipe ne sait plus expliquer une décision, vérifier un résultat, remplacer un fournisseur ou interrompre un processus automatisé sans arrêter son activité.
D’abord, la dépendance se repère dans les opérations quotidiennes : procédure connue seulement par l’outil, compétences internes qui disparaissent, données enfermées dans un format propriétaire ou processus impossible à reprendre manuellement.
La baisse de vigilance est un autre signal. Lorsque les utilisateurs valident automatiquement les sorties d’un modèle, l’organisation conserve une supervision nominale, mais perd la capacité réelle de contrôler les décisions.
Le gain de temps annoncé doit être comparé au temps de contrôle, de correction et de maintenance. Une automatisation qui économise vingt minutes de production, puis exige une heure de vérification sur chaque dossier, déplace le coût au lieu de le réduire.
Or les dépendances peuvent rester invisibles pendant plusieurs mois. Elles deviennent visibles lors d’une panne, d’un changement de tarif, d’une modification d’interface, d’un incident de sécurité ou d’une sortie de service.
Pour éviter cette situation, l’organisation doit conserver un mode dégradé : export des données, procédure manuelle, responsable identifié, journal des décisions et solution de remplacement. Un système critique sans possibilité d’arrêt maîtrisé est mal gouverné.
Les risques pour les entreprises et la responsabilité des acteurs
Une entreprise qui déploie une IA ne transfère pas automatiquement sa responsabilité au fournisseur. Selon le rôle joué par le fournisseur du modèle, l’intégrateur, le sous-traitant, le déployeur et l’utilisateur, plusieurs acteurs peuvent contribuer à un dommage ou devoir expliquer la chaîne de décision.
La responsabilité peut être partagée dans une chaîne complexe. Celui qui utilise, dirige et contrôle concrètement le système peut être regardé comme son gardien dans certaines analyses de responsabilité du fait des choses, tandis que le fournisseur de données ou le concepteur peut être impliqué selon l’origine du défaut.
Cette répartition ne se déduit pas d’un simple contrat commercial. Il faut documenter qui a choisi le modèle, défini l’objectif, sélectionné les données, réglé les seuils, validé le résultat et décidé de maintenir l’automatisation.
L’entreprise qui ne peut pas reconstituer une décision ne maîtrise pas son risque.
Les outils d’IA destinés à la vente ou à la relation client ajoutent un risque de promesse erronée. Un agent conversationnel peut fournir une information tarifaire incorrecte ou présenter une condition commerciale inexistante ; l’organisation doit alors prévoir un mécanisme de correction et un canal humain.
Que sait-on réellement des scénarios de perte de contrôle à long terme ?
Les scénarios de long terme liés à l’IA générale, à la superintelligence ou à un mauvais alignement des objectifs restent prospectifs. Des chercheurs étudient la possibilité qu’un système très autonome poursuive un objectif mal défini ou adopte des comportements imprévus, mais la probabilité, l’horizon et les conditions de ces scénarios ne sont pas établis par un consensus vérifiable.
D’abord, il faut séparer trois niveaux d’analyse. La perte de maîtrise organisationnelle est déjà possible lorsque les humains ne vérifient plus les sorties. L’autonomie technique croissante constitue un risque plausible dans certains déploiements. Le scénario existentiel relève d’une hypothèse débattue, pas d’un incident observé.
Les discussions sur l’alignement portent sur l’écart entre l’objectif formulé et l’intention humaine réelle. Une consigne peut être respectée littéralement tout en produisant un résultat contraire au but recherché, surtout lorsque les critères de réussite sont incomplets ou que le système peut agir sur plusieurs outils.
Le risque augmente lorsque l’agent dispose d’un accès large, de capacités d’exécution, d’un budget, d’une mémoire persistante ou d’un moyen de modifier son environnement. Ces facteurs ne prouvent pas qu’un système perdra le contrôle ; ils rendent indispensable une limitation précise des permissions.
Une croyance répandue mérite d’être écartée : « le scénario le plus spectaculaire est forcément le risque principal ». Les incidents actuels montrent plutôt l’importance des erreurs, des données exposées, des décisions non contestées et des dépendances opérationnelles.
Pour les systèmes avancés, les précautions raisonnables sont connues même lorsque la probabilité exacte ne l’est pas : tests adversariaux, séparation des privilèges, journalisation, surveillance indépendante, mécanisme d’arrêt et réévaluation avant chaque extension de capacité.
Il faut donc éviter deux excès. Présenter l’extinction comme une conséquence inévitable trompe le lecteur. Écarter toute réflexion sur l’alignement parce qu’elle est prospective prive les concepteurs d’un travail de prévention utile.
Comment réduire les risques de l’IA sur tout son cycle de vie ?
La réduction des risques repose sur une chaîne de mesures qui commence avant le choix du modèle et continue après le déploiement. Il faut limiter les données, tester la tâche réelle, contrôler les accès, former les utilisateurs, surveiller les résultats et pouvoir suspendre rapidement un système qui dérive.
D’abord, classifiez le projet avant de l’acheter ou de le développer. Notez le type de données, les personnes affectées, le niveau d’autonomie, la possibilité de recours et le coût d’un faux résultat.
Une méthode de gestion du risque sur le cycle de vie peut suivre ces étapes :
- Avant le déploiement : définir l’objectif, les exclusions, les données autorisées et les responsables.
- Pendant les tests : utiliser des cas normaux, des cas limites et des exemples susceptibles de révéler des biais.
- Au lancement : limiter les droits, conserver les journaux et imposer une validation humaine pour les actions sensibles.
- Après le lancement : mesurer les erreurs, les écarts entre groupes, les incidents et les contournements par les utilisateurs.
- En cas de dérive : réduire le périmètre, revenir à une version précédente ou arrêter le système.
Les mesures techniques comprennent la séparation des environnements, le contrôle des identités, la limitation des connecteurs, la protection des journaux et la détection des instructions malveillantes. Elles ne remplacent pas une règle claire sur les données que l’utilisateur peut transmettre.
Les mesures humaines sont tout aussi déterminantes : formation, procédure de recours, responsable désigné, documentation lisible et exercices de crise. L’article 4 du règlement européen sur l’IA prévoit des mesures de maîtrise de l’IA pour les personnes qui utilisent ou font fonctionner des systèmes pour le compte d’un fournisseur ou d’un déployeur ; cette obligation s’applique depuis le 2 février 2025.
Le calendrier du règlement européen doit être vérifié dans sa version officielle, car les obligations ne s’appliquent pas toutes à la même date. La page institutionnelle de l’AI Act Service Desk indique le 2 février 2025 pour les dispositions générales et les interdictions, le 2 août 2025 pour les règles concernant l’IA à usage général et la gouvernance, puis des échéances distinctes pour certains systèmes à haut risque, indiquées aux 2 août 2026 et 2 décembre 2027.
Le texte européen interdit certaines pratiques présentant un risque inacceptable à son article 5, prévoit une supervision humaine des systèmes à haut risque à son article 14 et impose des obligations de transparence pour certains contenus générés ou manipulés par IA à son article 50.
Le RGPD encadre également les décisions fondées exclusivement sur un traitement automatisé à son article 22. En cas de violation de données personnelles présentant un risque pour les droits et libertés, l’article 33 prévoit une notification à l’autorité compétente dans un délai maximal de 72 heures après en avoir pris connaissance.
Les sanctions prévues par le règlement européen sur l’IA peuvent atteindre 35 millions d’euros ou 7 % du chiffre d’affaires mondial annuel pour certaines violations, selon l’article 99, paragraphe 3. Le montant applicable dépend de la qualification juridique et de la situation concernée ; il doit être vérifié dans le texte à jour.
Tableau de synthèse des risques et des leviers de réduction
Le tableau suivant distingue les risques observables des scénarios plus incertains et associe chaque mécanisme à une action concrète. Il ne remplace pas une analyse juridique ou de sécurité adaptée à un système particulier.
| Risque | Mécanisme | Certitude | Conséquence possible | Levier prioritaire |
|---|---|---|---|---|
| Erreur ou hallucination | Réponse fausse formulée avec assurance | Constat actuel | Mauvaise décision ou désinformation | Vérification indépendante |
| Biais algorithmique | Données ou critères défavorisant un groupe | Constat actuel | Discrimination ou exclusion | Tests par groupe et recours humain |
| Fuite de données | Prompt, connecteur ou compte mal protégé | Risque actuel | Atteinte à la confidentialité | Classification des données et contrôle des accès |
| Cyberattaque | Injection, empoisonnement ou automatisation de fraude | Risque actuel | Vol, compromission ou usurpation | Tests adversariaux et séparation des privilèges |
| Dépendance | Compétences, données ou processus enfermés dans un outil | Risque organisationnel actuel | Perte de continuité et hausse des coûts | Mode dégradé et solution de remplacement |
| Perte de contrôle avancée | Autonomie et objectifs mal définis | Scénario prospectif | Action imprévue ou dommage difficile à contenir | Limitation des permissions et arrêt maîtrisé |
Une checklist individuelle peut rester courte :
- ne pas saisir de secret professionnel, de mot de passe ou de donnée personnelle inutile ;
- vérifier toute information factuelle importante dans une source indépendante ;
- signaler clairement les contenus générés lorsqu’un lecteur pourrait les confondre avec un document humain ;
- conserver une validation humaine pour une décision qui affecte une personne ;
- prévoir une solution manuelle avant d’automatiser une tâche critique.
Mais ces réflexes ne suffisent pas pour une organisation entière. Il faut aussi savoir qui paie le coût des contrôles, qui assume l’incident et qui peut interrompre le déploiement sans attendre l’autorisation du fournisseur.
Questions fréquentes sur les risques de l’IA
Quels effets l’IA peut-elle avoir sur l’apprentissage et l’attention ?
Un usage passif, où l’outil fournit directement les réponses, peut réduire l’effort de mémorisation, de raisonnement et de rédaction. Utilisée comme aide pour obtenir des explications, comparer des méthodes ou s’entraîner, l’IA peut au contraire soutenir l’apprentissage. L’effet dépend donc surtout de la place laissée à la réflexion et à la vérification personnelle.
Quel est l’impact environnemental de l’intelligence artificielle ?
L’IA consomme de l’électricité pour entraîner les modèles, traiter les requêtes et faire fonctionner les centres de données. Son impact inclut aussi l’eau utilisée pour certains systèmes de refroidissement ainsi que la fabrication et le renouvellement des équipements informatiques. Il varie selon la taille du modèle, la fréquence d’utilisation, le matériel et la source d’énergie employée.
Quel arbitrage retenir face aux risques de l’intelligence artificielle ?
Les erreurs, les biais, les fuites de données et la perte de contrôle forment une chaîne lorsqu’un résultat produit automatiquement est accepté sans vérification. L’analyse des risques de l’IA doit donc partir de l’usage réel, mesurer le dommage possible et maintenir une capacité concrète de contestation, d’arrêt et de remplacement.
D’abord, traitez les risques actuels avant les scénarios les plus spéculatifs : hallucinations, décisions biaisées, confidentialité, attaques et dépendance opérationnelle. Ensuite, adaptez le niveau de contrôle à la gravité d’une erreur, au nombre de personnes touchées et à la difficulté de revenir en arrière.
Une IA convient à une tâche lorsque son résultat est vérifiable et réversible. Elle ne convient pas comme arbitre unique lorsque la décision engage durablement une personne.
La technologie apporte alors un gain mesurable seulement si l’équipe conserve ses compétences, ses données, ses procédures et son pouvoir d’interruption. Le bénéfice disparaît quand l’organisation contourne l’outil, corrige ses erreurs en silence ou paie une maintenance supérieure au temps économisé.
La bonne décision n’est donc ni l’adoption enthousiaste ni l’interdiction générale. Elle consiste à comparer le gain réellement récupéré, le coût de supervision, la dépendance créée et la gravité d’un échec, puis à renoncer si le contrôle nécessaire est impossible à maintenir à ce prix.