
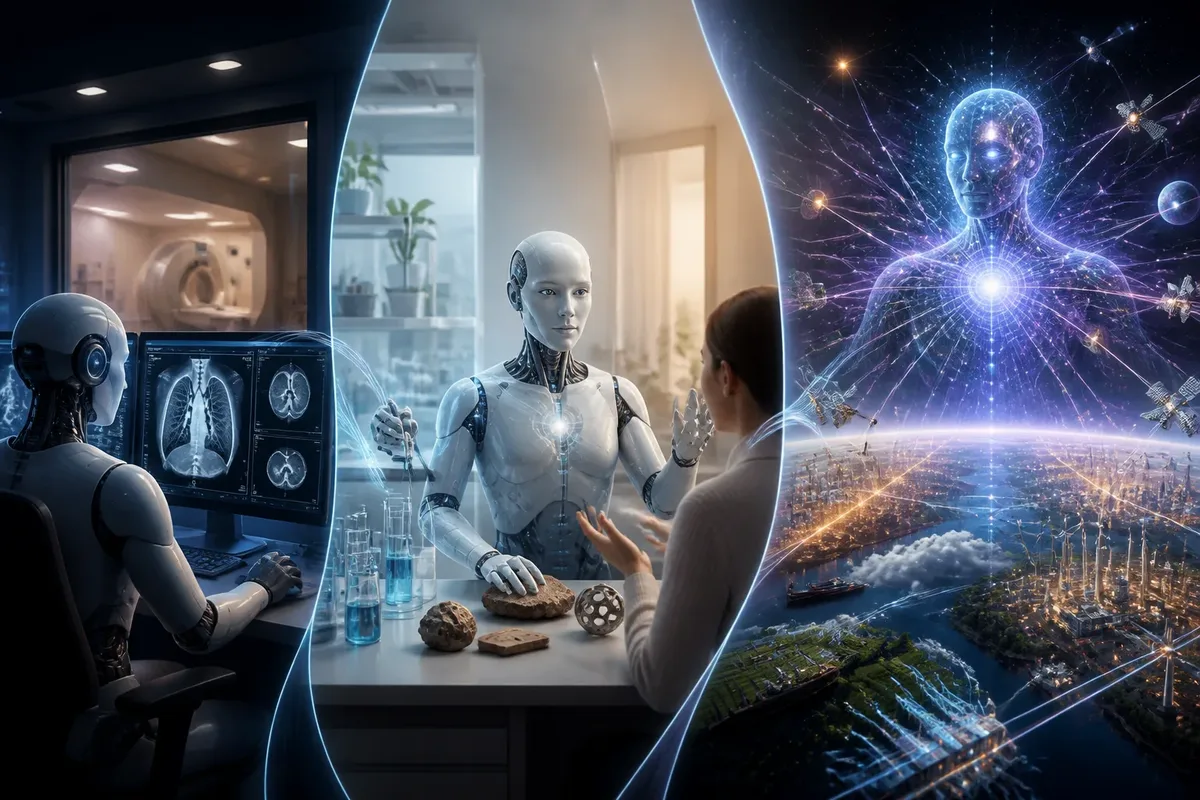
Trois catégories d’intelligence artificielle circulent souvent dans les articles, avec un coût de confusion élevé pour le lecteur : l’IA spécialisée existe largement, l’IA générale reste théorique et la superintelligence relève de la prospective. Pour les distinguer, observez la tâche réalisée, l’adaptation à des situations nouvelles, puis le niveau de performance revendiqué.
Une même technologie peut pourtant recevoir plusieurs étiquettes : générative par sa fonction, connexionniste par son architecture, spécialisée par son périmètre et parfois agentique par son degré d’autonomie. Ce guide permet donc de reconnaître le type d’IA évoqué, de séparer les faits des hypothèses et d’éviter de prendre un outil impressionnant pour une intelligence générale.
Avant de commencer : pourquoi existe-t-il plusieurs classements de l’IA ?
D’abord, il n’existe pas une classification unique et définitivement admise des types d’intelligence artificielle, car les catégories ne décrivent pas toutes la même chose : certaines portent sur les capacités, d’autres sur l’apprentissage, l’architecture, la fonction ou le lieu d’exécution.
Le nombre de catégories dépend donc de la question posée. Une taxonomie par capacités peut distinguer l’IA réactive, l’IA à mémoire limitée, l’IA générale et des formes encore théoriques. Une autre s’intéresse aux méthodes et oppose les approches symboliques, statistiques ou connexionnistes.
Le bon classement est celui qui répond au critère recherché. Une IA générative produit du contenu. Une IA spécialisée accomplit un périmètre déterminé. Une IA embarquée fonctionne au plus près d’un appareil ou d’un véhicule. Ces descriptions peuvent concerner le même système sans se contredire.
Or, les articles de vulgarisation mélangent parfois ces niveaux. Le terme « IA forte » peut désigner une ambition générale, tandis que « IA faible » décrit souvent un système spécialisé, sans mesurer directement sa qualité technique.
D’abord, retenez cette règle de lecture : demandez toujours si l’auteur parle d’une capacité, d’une méthode d’apprentissage, d’une architecture, d’une application ou d’un degré d’autonomie.
- Capacité : le système agit-il dans une tâche précise ou dans de nombreux domaines ?
- Technologie : apprend-il à partir de données, applique-t-il des règles, ou combine-t-il plusieurs approches ?
- Fonction : prédit-il, recommande-t-il, génère-t-il un contenu ou exécute-t-il une action ?
- Autonomie : attend-il une instruction à chaque étape ou enchaîne-t-il plusieurs opérations ?
La définition juridique européenne aide à cadrer le terme sans fournir une liste de trois types. Le règlement (UE) 2024/1689 décrit un système d’IA par sa capacité à produire notamment des contenus, des prédictions, des recommandations ou des décisions. Cette définition sert à identifier un système, pas à trancher son niveau d’intelligence.
Étape 1 : comment reconnaître une intelligence artificielle spécialisée ?
D’abord, une IA spécialisée accomplit une tâche ou un ensemble de tâches défini, même lorsqu’elle produit des résultats variés et donne l’impression d’échanger comme un humain. Elle fonctionne dans un périmètre construit par ses données, ses objectifs, ses outils disponibles et ses conditions d’utilisation.
Un filtre anti-spam classe des messages. Un moteur de recommandation estime les contenus susceptibles d’intéresser un utilisateur. Un outil de transcription transforme une voix en texte. Chacun peut être performant dans son domaine tout en restant inadapté à une tâche différente.
La production de texte ne change pas automatiquement cette classification. Une IA générative qui rédige une annonce, résume un document ou propose du code produit plusieurs formes de contenu, mais elle reste évaluée sur des tâches et des consignes particulières.
Le nom commercial ne suffit pas. Un assistant capable de répondre à des demandes variées peut dépendre d’un modèle, d’une base documentaire, d’un moteur de recherche et d’outils externes, avec des limites propres à chaque composant.
Mais une conversation fluide ne démontre aucune conscience. Elle montre qu’un système produit une réponse cohérente dans un contexte donné, pas qu’il possède une expérience subjective, des intentions ou une compréhension humaine du monde.
D’abord, vérifiez la limite concrète : que se passe-t-il lorsque la demande sort des données, des outils ou des consignes prévus ?
Étape 1 : repérer la tâche réellement accomplie
Commencez par formuler le verbe d’action. « Classer des images », « prédire une demande », « générer un texte » ou « détecter une anomalie » décrit mieux le système que son étiquette marketing.
Observez ensuite l’entrée et la sortie. Un modèle de vision reçoit une image et renvoie une classe ou une description. Un modèle prédictif reçoit des variables et estime une valeur. Le système peut être sophistiqué sans changer de catégorie.
Étape 2 : tester la sortie du périmètre
Formulez une demande voisine, puis une demande étrangère à la mission initiale. Une IA spécialisée peut réussir plusieurs variantes d’une tâche, tout en échouant lorsqu’on lui demande une compétence éloignée ou une décision nécessitant un contexte absent.
Le résultat attendu après ce test est simple : vous devez pouvoir nommer la frontière du système. Si cette frontière reste floue, l’étiquette « intelligente » ne vous aide pas encore.
Étape 3 : séparer génération et généralité
Un système génératif crée du texte, des images, de l’audio, de la vidéo ou du code à partir d’une consigne. Cette fonction décrit le résultat produit, tandis que l’IA générale désigne une capacité beaucoup plus large d’adaptation et de résolution de problèmes.
Un logiciel de rédaction assistée par IA peut donc être utile pour produire des contenus sans devenir une intelligence générale. Sa valeur dépend de la qualité des données, du contrôle humain, de l’intégration au flux de travail et du coût de maintenance.
Pour comparer des usages concrets, les logiciels de rédaction IA comparés constituent un exemple de catégorie fonctionnelle, pas une preuve de généralité.
Étape 2 : que recouvre l’intelligence artificielle générale ?
D’abord, l’intelligence artificielle générale désigne l’hypothèse d’un système capable de mobiliser des compétences dans de nombreux domaines, de s’adapter à des situations nouvelles et de résoudre des problèmes sans rester enfermé dans une tâche déterminée.
Cette notion demeure théorique et ses critères exacts font débat. Aucun seuil universel ne permet de déclarer qu’un système possède une intelligence générale, car il faudrait définir l’ensemble des tâches, le degré d’adaptation attendu et la comparaison pertinente avec les humains.
Une IA générale n’est pas établie par une conversation convaincante. Elle devrait démontrer une polyvalence durable, transférer des connaissances entre des domaines éloignés et fonctionner dans des situations nouvelles sans dépendre d’une préparation spécifique pour chaque cas.
La difficulté tient aussi à la mesure. Un système peut exceller à certaines évaluations, produire des textes convaincants et utiliser plusieurs modalités sans maîtriser pour autant la planification longue, la vérification autonome de ses erreurs ou l’action fiable dans le monde physique.
Pour juger une affirmation, remplacez le mot « général » par des capacités observables. L’outil apprend-il une tâche nouvelle avec peu d’exemples ? Transfère-t-il correctement une compétence ? Reconnaît-il ses limites ? Maintient-il ses performances quand le contexte change ?
Pour l’instant, une annonce qui présente un outil actuel comme une preuve définitive d’IA générale va trop loin. Elle confond progression de performances, multiplication des usages et changement de nature du système.
Ensuite, regardez les conditions de déploiement. Un assistant peut paraître polyvalent parce qu’il combine un modèle, une recherche documentaire, des extensions et une supervision humaine, ce qui ne suffit pas à établir une intelligence générale autonome.
Les critères à examiner
Une analyse sérieuse porte sur le transfert, l’adaptation et la robustesse. Ces critères ne forment pas un examen officiel, mais ils évitent de conclure à partir d’une seule démonstration soigneusement préparée.
- Transfert : la compétence acquise dans un domaine aide-t-elle réellement dans un autre ?
- Adaptation : le système apprend-il une situation nouvelle sans réentraînement spécifique ?
- Robustesse : les résultats restent-ils fiables quand les données sont incomplètes ou ambiguës ?
- Autonomie : le système vérifie-t-il ses actions et leurs conséquences sans supervision constante ?
D’abord, demandez la preuve exacte avancée. Une démonstration publique, un score de benchmark ou une déclaration d’entreprise ne répond pas nécessairement aux quatre critères.
Étape 3 : que signifie une intelligence artificielle dépassant les capacités humaines ?
D’abord, la superintelligence désigne une hypothèse selon laquelle une IA dépasserait les meilleures capacités humaines dans la plupart des domaines importants, et non une simple supériorité sur une tâche isolée comme un calcul ou un jeu.
La comparaison devrait couvrir l’apprentissage, le raisonnement, la créativité, la planification, la communication et l’action, avec des critères suffisamment précis pour éviter de transformer une performance locale en conclusion générale.
Un programme qui calcule plus vite qu’un humain n’est pas automatiquement une superintelligence. La vitesse appartient à une dimension précise. La notion prospective suppose un avantage très large et durable sur des capacités hétérogènes.
Pourtant, les descriptions médiatiques rapprochent parfois cette hypothèse de l’IA consciente ou de la théorie de l’esprit. Ces notions se recouvrent dans certains récits, mais elles ne décrivent pas exactement la même propriété.
La théorie de l’esprit renvoie à la capacité supposée de comprendre les croyances, les intentions ou les émotions d’autrui. Une IA consciente impliquerait une expérience subjective. Les réponses produites par un modèle ne démontrent ni l’une ni l’autre.
D’abord, traitez toute affirmation de superintelligence comme une projection tant qu’elle ne fournit pas de définition opérationnelle, de périmètre de comparaison et de résultats vérifiables sur plusieurs familles de tâches.
Dans ce cas, ne faites pas confiance au seul vocabulaire employé. Les mots « autonome », « raisonnant » ou « surhumain » peuvent décrire une fonction limitée, une expérimentation ou une ambition commerciale.
Étape 4 : comment comparer les trois catégories sans se tromper ?
D’abord, utilisez les mêmes critères pour chaque catégorie : périmètre d’action, adaptation, statut actuel et niveau de preuve. Cette méthode transforme une liste de définitions en grille de lecture réutilisable devant un article, une vidéo, une démonstration ou une promesse commerciale.
| Catégorie | Périmètre d’action | Adaptation attendue | Statut |
|---|---|---|---|
| IA spécialisée | Tâche ou groupe de tâches défini | Limitée par les données, les objectifs et les outils disponibles | Disponible et largement utilisée |
| IA générale | Nombreux domaines et problèmes variés | Transfert de compétences et adaptation à des situations nouvelles | Concept théorique ou prospectif |
| Superintelligence | La plupart des domaines importants | Performances supérieures aux meilleures capacités humaines | Hypothèse prospective |
Le tableau donne une distinction pratique, pas une norme scientifique universelle. Il répond à la question « quel niveau de capacité est revendiqué ? », alors que d’autres classements décrivent la méthode ou l’usage.
Mais une même application peut apparaître dans plusieurs lignes selon le critère retenu. Une IA générative peut être spécialisée, reposer sur une architecture connexionniste et être intégrée à un agent capable d’enchaîner des actions.
Pour classer un outil, ne partez jamais de son nom. Décrivez ce qu’il reçoit, ce qu’il produit, ce qu’il peut apprendre et ce qu’il fait sans intervention humaine.
La méthode de classement en trois questions
- Que fait précisément le système ? Identifiez la tâche, la sortie et les outils utilisés.
- Que se passe-t-il hors de cette tâche ? Testez le transfert, la nouveauté et les limites documentées.
- Quelle preuve soutient l’étiquette ? Distinguez une démonstration, une mesure indépendante, une hypothèse ou une promesse.
Or, une affirmation qui ne répond à aucune de ces questions reste trop vague pour permettre un classement fiable. Le lecteur doit pouvoir expliquer son choix avec des faits observables, pas avec la puissance commerciale d’une marque.
Quels autres types d’IA faut-il distinguer ?
D’abord, les catégories techniques décrivent des niveaux différents. Le machine learning est une manière d’apprendre à partir de données, le deep learning une famille d’approches fondées sur des réseaux neuronaux profonds, tandis qu’une application d’IA combine souvent plusieurs modèles et composants.
L’apprentissage supervisé utilise des exemples associés à une réponse attendue. L’apprentissage non supervisé recherche des structures dans des données sans étiquette fournie de la même manière. L’apprentissage auto-supervisé construit des signaux d’apprentissage à partir des données elles-mêmes.
L’apprentissage par renforcement repose sur des actions évaluées par des récompenses ou des pénalités. Il convient à certains problèmes de décision séquentielle, mais son emploi ne transforme pas automatiquement un système en IA générale.
Les approches symboliques manipulent des règles, des relations ou des représentations explicites. Les approches connexionnistes apprennent des régularités à partir d’exemples. Les systèmes neuro-symboliques cherchent à combiner apprentissage statistique et raisonnement structuré.
Les réseaux convolutifs sont souvent associés aux images et aux données organisées en grille. Les réseaux récurrents ont été utilisés pour des données séquentielles, comme le langage ou les séries temporelles. Ces associations décrivent des architectures, non des niveaux d’intelligence.
Ensuite, il faut distinguer le modèle de l’application. Un modèle est un composant entraîné. Une application ajoute une interface, des données, des règles d’accès, des outils et parfois une mémoire de travail. Le résultat visible dépend de l’ensemble.
Comment distinguer IA générative, copilote, agent et IA embarquée ?
D’abord, l’IA générative produit un contenu à partir d’une instruction ou d’un contexte, tandis qu’un copilote accompagne une tâche humaine, un agent enchaîne des opérations et une IA embarquée s’exécute directement dans un appareil ou un véhicule.
Un générateur de texte peut rédiger une réponse. Un copilote peut proposer une formulation dans un logiciel. Un agent peut rechercher une information, appeler un outil et préparer une action selon les autorisations reçues. Ces fonctions se combinent parfois dans une même application.
L’autonomie ne doit pas être confondue avec l’intelligence générale. Un agent doté de plusieurs outils peut agir sur une séquence précise, avec des permissions, des règles et des objectifs définis par son concepteur.
L’IA hybride combine plusieurs approches ou composants. L’IA fédérée entraîne un modèle en laissant les données sur plusieurs appareils ou sites, puis échange des mises à jour du modèle selon l’architecture retenue. Elle décrit une organisation des données, pas une intelligence supérieure.
Une IA embarquée doit respecter les contraintes de son matériel, de sa latence, de son énergie et de son environnement. Elle peut détecter un objet ou ajuster un paramètre sans comprendre le monde comme un humain.
Pour une entreprise, le point décisif reste le déploiement. Une automatisation agentique promet du temps gagné, mais elle ajoute des droits d’accès, des journaux, des contrôles et une maintenance que l’équipe doit réellement financer.
Et si la promesse porte sur un agent IA pour vendre sur WhatsApp, examinez séparément la génération de messages, l’accès aux données, l’attribution des conversions et la supervision humaine grâce à un avis sur cet agent IA.
D’abord, mesurez l’action finale obtenue. Une réponse générée n’a pas la même valeur qu’une tâche correctement exécutée et vérifiée.
Quelles erreurs empêchent de bien vérifier une affirmation sur l’IA ?
D’abord, ne reprenez pas le vocabulaire d’un communiqué sans observer le système réel : identifiez sa tâche, ses données d’entrée, ses outils, ses conditions de test et le contrôle exercé par un humain.
« Un chatbot est une IA générale » est une idée reçue fréquente. Elle confond variété des conversations et généralité des compétences. Un système peut répondre sur de nombreux sujets tout en produisant des erreurs, en dépendant de son contexte et en échouant dans une situation nouvelle.
Une autre erreur consiste à classer les outils selon leur popularité. Le nombre d’utilisateurs, la valorisation d’un éditeur ou la visibilité d’une application ne mesure ni sa polyvalence ni sa fiabilité.
Vérifiez aussi les conditions cachées. Le système fonctionne-t-il avec une base documentaire préparée ? Une personne corrige-t-elle les sorties ? Les résultats sont-ils obtenus sur des exemples sélectionnés ? L’outil dispose-t-il d’un accès à Internet ou à des logiciels externes ?
Pour les données sensibles, ajoutez les questions de gouvernance. Où les informations sont-elles traitées ? Qui peut les consulter ? Combien de temps sont-elles conservées ? Les utilisateurs savent-ils quand une décision ou une recommandation dépend d’un système automatisé ?
Les limites ne sont pas secondaires. Une donnée biaisée, une consigne ambiguë ou une sortie plausible mais fausse peut transformer un gain de temps annoncé en reprise manuelle, en erreur client ou en dépendance durable à un fournisseur.
Pourtant, toutes les erreurs ne se corrigent pas avec un modèle plus puissant. Certaines viennent du processus, de l’absence de validation, de permissions trop larges ou d’une attribution impossible entre l’automatisation et le résultat obtenu.
D’abord, écrivez une fiche courte avant d’adopter l’outil :
- tâche automatisée et résultat attendu ;
- données utilisées et niveau de sensibilité ;
- personne responsable de la vérification ;
- solution de secours en cas d’erreur ou d’indisponibilité ;
- coût récurrent, maintenance et dépendance au fournisseur.
Cette méthode permet de distinguer une avancée réellement utile d’un discours qui change seulement l’étiquette. Le gain disparaît quand l’équipe contourne l’outil, corrige chaque sortie ou maintient deux systèmes en parallèle.
Foire aux questions sur les types d’intelligence artificielle
Une intelligence artificielle peut-elle fonctionner sans connexion Internet ?
Oui, si son modèle, ses données et les ressources nécessaires sont installés directement sur l’appareil ou sur un serveur local. Cette exécution peut réduire la dépendance au cloud, mais elle exige suffisamment de puissance de calcul, de mémoire et de stockage.
Pourquoi une IA peut-elle produire une réponse fausse avec assurance ?
Une IA générative produit une réponse en s’appuyant sur des régularités apprises et non sur une garantie automatique de vérité. Elle peut donc compléter une information absente, mal interpréter une consigne ou combiner des éléments incompatibles tout en formulant le résultat de manière convaincante.